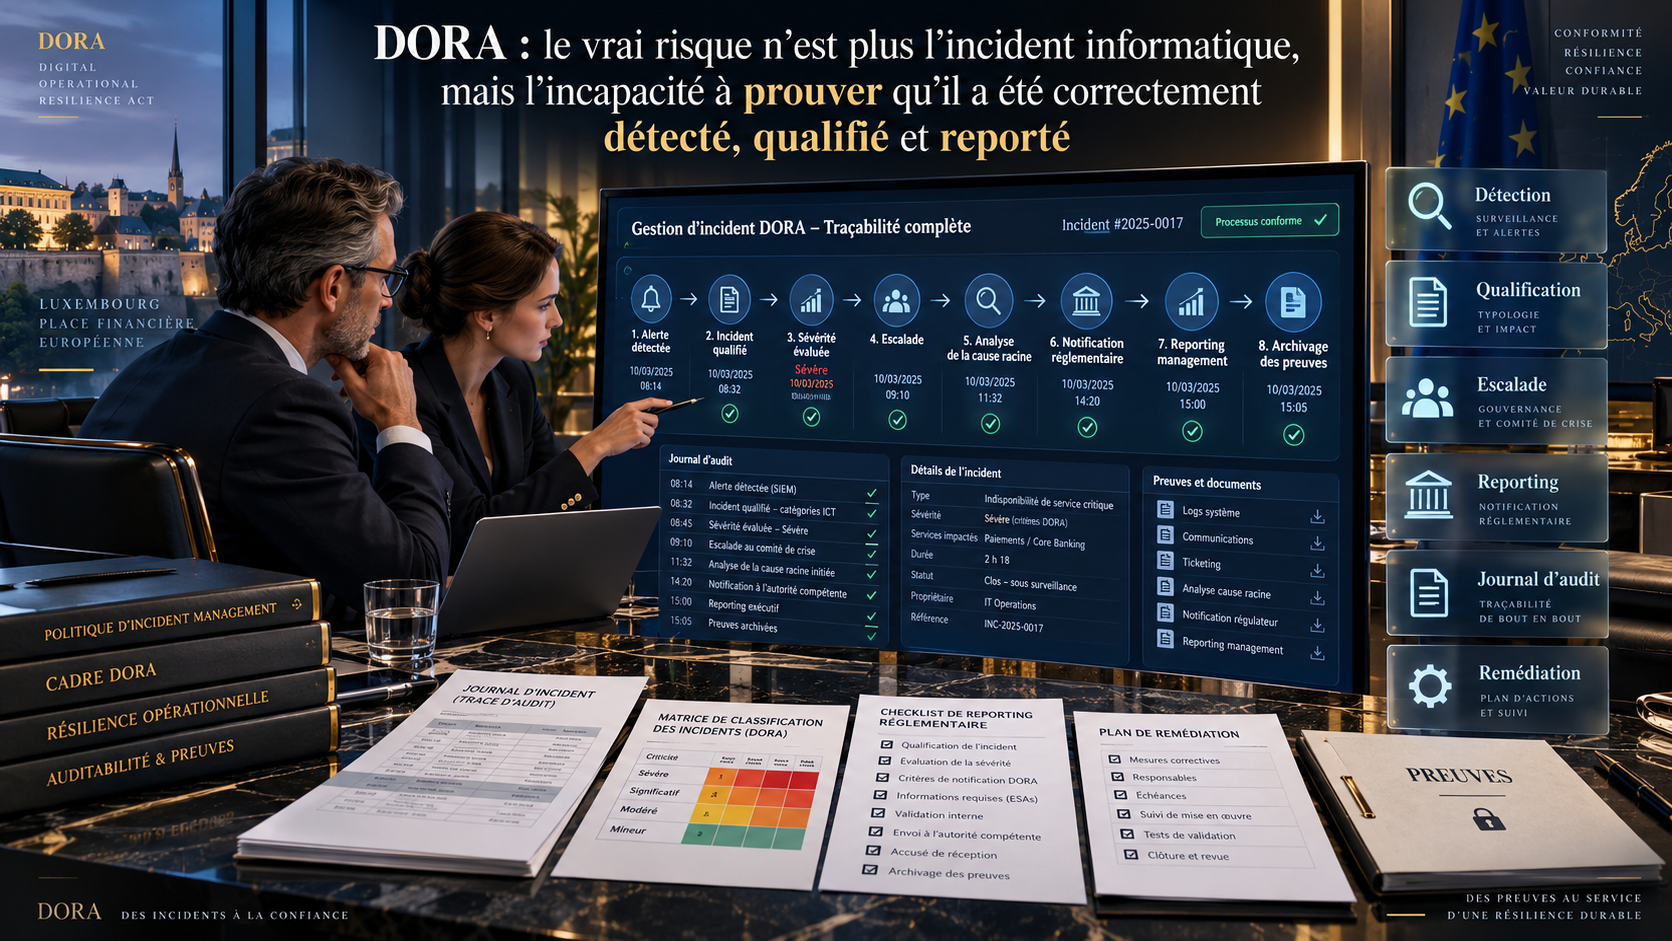
Depuis DORA, subir un incident informatique n’est pas nécessairement un échec réglementaire. En revanche, être incapable de démontrer quand l’incident a été détecté, comment il a été évalué, pourquoi il a été classé comme majeur, ou non, et dans quels délais il a été notifié peut rapidement le devenir.
Un serveur tombe.
Une application devient indisponible.
Un prestataire informatique informe l’entreprise d’un incident de cybersécurité.
Des données deviennent temporairement inaccessibles.
Une activité critique est perturbée pendant plusieurs heures.
Dans les premières minutes, les équipes cherchent naturellement à résoudre le problème.
C’est indispensable.
Mais depuis l’entrée en application de DORA, le 17 janvier 2025, une deuxième horloge tourne en parallèle.
Une horloge réglementaire.
Elle ne mesure pas seulement le temps nécessaire pour restaurer les systèmes.
Elle mesure le temps nécessaire pour :
- détecter ;
- documenter ;
- classifier ;
- escalader ;
- notifier ;
- mettre à jour ;
- et expliquer.
C’est précisément là que se situe probablement l’un des risques DORA les plus sous-estimés.
Le risque n’est plus simplement :
« Avons-nous subi un incident informatique ? »
La question devient :
« Pourrions-nous démontrer, six mois plus tard devant la CSSF, exactement ce que nous savions à chaque moment critique et pourquoi nous avons pris la décision de notifier — ou de ne pas notifier ? »
La distinction est fondamentale.
1. DORA n’exige pas l’absence d’incidents. Il exige leur maîtrise.
Aucune infrastructure informatique sérieuse ne peut raisonnablement garantir qu’aucun incident ne surviendra jamais.
DORA ne repose d’ailleurs pas sur cette fiction.
Le règlement européen organise au contraire un cadre permettant aux entités financières d’identifier, gérer, enregistrer, classifier et, lorsque les critères sont atteints, notifier les incidents majeurs liés aux technologies de l’information et de la communication.
Pour les entités relevant de DORA, l’incident devient donc un objet réglementaire.
À partir du moment où un événement survient, plusieurs questions commencent immédiatement à produire des conséquences :
Quand l’entité en a-t-elle eu connaissance ?
Quand a-t-elle disposé d’informations suffisantes pour l’évaluer ?
Quels critères de classification ont été examinés ?
Quand l’incident a-t-il été considéré comme majeur ?
Qui a pris cette décision ?
Sur quelles informations ?
Quand l’autorité compétente a-t-elle été informée ?
Ces questions ne sont pas théoriques.
Elles déterminent directement le respect des délais de notification.
2. Le détail qui change tout : le délai ne commence pas uniquement avec la notification
Le règlement délégué (UE) 2025/301 fixe désormais très précisément les délais applicables.
La notification initiale d’un incident majeur doit être effectuée le plus tôt possible, et en tout état de cause dans les quatre heures suivant sa classification comme incident majeur, sans dépasser 24 heures à compter du moment où l’entité financière a pris connaissance de l’incident.
Le rapport intermédiaire doit ensuite être transmis au plus tard 72 heures après la notification initiale, même lorsque la situation n’a pas évolué.
Le rapport final doit, en principe, être soumis au plus tard un mois après le rapport intermédiaire ou, le cas échéant, après sa dernière mise à jour.
Cette mécanique réglementaire crée une difficulté particulièrement intéressante.
Il existe au moins deux moments différents à documenter :
T0 : awareness of the incident
et
T1 : classification as major.
Entre les deux se déroule tout le processus d’analyse.
Et c’est précisément cette période qui peut devenir extrêmement sensible lors d’une inspection.
Car une question évidente peut apparaître :
Pourquoi l’incident n’a-t-il été classé comme majeur qu’à 17h42 alors que vos équipes en avaient connaissance depuis 09h15 ?
Pour répondre correctement, une entreprise doit disposer de beaucoup plus qu’un formulaire de notification.
Elle doit disposer de la preuve de son raisonnement.
3. Le véritable risque DORA pourrait donc être le “decision gap”
Prenons un cas volontairement simple.
À 08h47, un prestataire ICT informe l’entreprise qu’un service utilisé par plusieurs fonctions est indisponible.
À 09h05, IT ouvre un ticket.
À 09h30, le problème est considéré comme technique et temporaire.
À 11h15, l’indisponibilité continue.
À 13h40, les équipes réalisent que certaines opérations critiques ne peuvent plus être exécutées.
À 15h10, Compliance et Risk sont informés.
À 16h00, une première évaluation DORA est réalisée.
À 18h00, l’incident est classé comme majeur.
La question du superviseur pourrait ne pas porter uniquement sur la notification effectuée après 18h00.
Elle pourrait porter sur les neuf heures précédentes.
Pourquoi Compliance n’a-t-elle été informée qu’à 15h10 ?
Quels critères de matérialité étaient disponibles à 11h15 ?
Existe-t-il une règle claire permettant à IT de savoir quand déclencher l’analyse réglementaire ?
Quelqu’un a-t-il documenté à 13h40 le fait qu’une fonction critique était impactée ?
Qui disposait de l’autorité permettant de classifier l’incident ?
Pourquoi la classification a-t-elle nécessité près de deux heures supplémentaires ?
Toutes ces questions examinent la même chose :
la qualité du processus de décision.
4. Un incident bien géré mais mal documenté peut devenir un mauvais dossier réglementaire
Imaginons maintenant que les équipes aient réagi de manière excellente.
Le système est isolé.
Les utilisateurs sont informés.
Le fournisseur est challengé.
Le business continuity plan est activé.
Le service est restauré.
Aucune donnée n’est perdue.
Aucun investisseur ne subit de préjudice.
Opérationnellement, l’incident a été remarquablement géré.
Mais six mois plus tard, lors d’une inspection, personne n’est capable de déterminer avec certitude :
quand l’incident a été détecté ;
quand le management en a eu connaissance ;
quand il a été considéré comme potentiellement majeur ;
quels critères réglementaires ont été testés ;
qui a validé la classification ;
pourquoi certains seuils ont été considérés comme atteints ou non atteints.
L’entreprise dispose de centaines d’e-mails.
De messages Teams.
De tickets IT.
De rapports du prestataire.
De captures d’écran.
Mais pas d’une chronologie réglementaire consolidée.
C’est là que le problème apparaît.
L’organisation possède de l’information.
Mais elle ne possède pas nécessairement de preuve.
5. Sous DORA, l’horodatage devient presque aussi important que le contenu
Dans beaucoup de processus de compliance traditionnels, il est essentiel de démontrer ce qui a été décidé.
Dans la gestion des incidents DORA, il devient tout aussi important de démontrer quand cette décision a été prise.
Prenons une phrase apparemment anodine :
« The incident was assessed as major. »
Elle est insuffisante.
Il faut potentiellement être capable de démontrer :
18:02 — les derniers éléments nécessaires à la classification sont reçus ;
18:07 — l’évaluation des critères DORA est complétée ;
18:14 — Risk confirme que les seuils sont atteints ;
18:19 — Compliance confirme l’obligation de reporting ;
18:24 — le responsable autorisé valide la classification ;
18:37 — préparation de la notification ;
19:03 — transmission à l’autorité compétente.
Cette chronologie transforme une affirmation en preuve.
Elle permet surtout de répondre à la question réglementaire la plus importante :
L’organisation a-t-elle agi sans retard injustifié dès qu’elle disposait de l’information pertinente ?
6. Le 29 septembre 2026, la CSSF a envoyé un signal particulièrement clair
Le sujet est devenu encore plus actuel au Luxembourg.
Le 29 septembre 2026, soit moins d’une semaine avant la rédaction du présent article, la CSSF a publié des instructions opérationnelles complémentaires concernant la notification des incidents majeurs liés aux TIC dans le cadre de DORA.
La CSSF rappelle notamment les instructions opérationnelles publiées par les autorités européennes de supervision et précise que ces orientations doivent permettre d’améliorer la qualité des informations communiquées, d’harmoniser les pratiques de notification et de réduire les échanges ultérieurs avec les autorités.
Le message mérite d’être lu au-delà de sa dimension technique.
Le superviseur ne s’intéresse pas seulement au fait qu’un rapport ait été transmis.
Il s’intéresse à la qualité de ce qui est transmis.
Autrement dit :
reporting effectué ne signifie pas nécessairement reporting maîtrisé.
La notification devient elle-même un processus de contrôle réglementaire.
7. La classification est probablement le cœur du dispositif
Toute la mécanique repose sur une étape particulièrement délicate :
la qualification de l’incident.
Tous les incidents ICT ne sont évidemment pas des incidents majeurs au sens de DORA.
Le processus de classification doit donc être suffisamment robuste pour distinguer :
un événement technique mineur ;
un incident ICT ;
un incident présentant un impact matériel ;
et un incident répondant aux critères réglementaires de major incident.
Mais cette analyse doit également être reproductible.
Une organisation mature ne devrait jamais se trouver dans une situation où la conclusion dépend essentiellement de la personne présente ce jour-là.
Deux personnes différentes confrontées au même événement devraient parvenir à une conclusion réglementaire raisonnablement comparable.
Cela suppose :
des critères clairement documentés ;
des sources de données identifiées ;
des responsabilités définies ;
une méthodologie commune ;
et une gouvernance d’escalade.
Sinon, le risque apparaît immédiatement :
le même incident pourrait être “major” le lundi et “non-major” le vendredi selon la personne réalisant l’analyse.
Ce n’est pas un problème informatique.
C’est un problème de gouvernance.
8. La décision de ne pas reporter doit être aussi documentée que celle de reporter
Voici probablement l’un des points les plus importants.
Les organisations ont naturellement tendance à documenter soigneusement les incidents ayant fait l’objet d’une notification.
Mais qu’en est-il des incidents analysés puis considérés comme non reportables ?
Ce sont parfois eux qui présentent le risque réglementaire le plus important.
Pourquoi ?
Parce qu’un superviseur peut parfaitement sélectionner a posteriori un incident figurant dans le registre interne et demander :
« Pourquoi cet incident n’a-t-il pas été notifié ? »
Une réponse telle que :
« Nous avions considéré qu’il n’était pas suffisamment important »
est extrêmement fragile.
Une réponse robuste serait plutôt :
« Nous avons appliqué les critères de classification DORA le 14 avril à 10h35. Les critères A et B étaient satisfaits, mais les seuils X, Y et Z ne l’étaient pas sur la base des données disponibles à cette date. L’évaluation a été revue à 15h00 après réception d’informations complémentaires et la conclusion est restée inchangée. Voici l’analyse, les données sources et les validations. »
La différence entre les deux est immense.
La première est une opinion.
La seconde est une position réglementaire démontrable.
9. Le “DORA incident evidence pack”
C’est probablement ici que les organisations financières peuvent faire évoluer leur dispositif.
Chaque incident présentant une matérialité suffisante devrait pouvoir être reconstitué à travers un dossier standardisé que l’on pourrait appeler :
DORA Incident Evidence Pack
Il ne s’agirait pas d’ajouter de la bureaucratie.
Il s’agirait de transformer des informations dispersées en chaîne de preuve cohérente.
Le dossier devrait notamment permettre de retrouver immédiatement :
1. Detection
Quand l’incident est-il apparu ?
Quand a-t-il été détecté ?
Par quel système ou quelle personne ?
2. Awareness
Quand l’organisation en a-t-elle eu connaissance ?
Quelle fonction était informée ?
Existe-t-il une preuve horodatée ?
3. Initial assessment
Quelle était l’information disponible au départ ?
Quelles hypothèses ont été formulées ?
4. DORA classification
Quels critères réglementaires ont été évalués ?
Quels seuils étaient atteints ?
Lesquels ne l’étaient pas ?
5. Decision
Qui a décidé de classer l’incident comme majeur ou non majeur ?
À quelle heure ?
6. Escalation
Quand IT, Risk, Compliance, le senior management ou les organes de gouvernance concernés ont-ils été informés ?
7. Regulatory reporting
Quand la notification initiale a-t-elle été envoyée ?
Quand les rapports intermédiaires ont-ils été transmis ?
Le rapport final ?
8. Remediation
Quelles mesures ont été prises ?
Quelles actions restent ouvertes ?
9. Root cause
Quelle était la cause profonde ?
Interne ?
Prestataire ?
Configuration ?
Erreur humaine ?
Cyberattaque ?
10. Lessons learned
Qu’a changé l’organisation à la suite de l’incident ?
Sans cette dernière étape, l’organisation gère des événements.
Elle ne construit pas nécessairement de résilience.
10. Un fichier Excel des incidents ne constitue pas nécessairement un Incident Management Framework
De nombreuses organisations disposent aujourd’hui d’un incident register.
Date.
Description.
Impact.
Owner.
Status.
Cela constitue un bon point de départ.
Mais le simple enregistrement des incidents ne suffit pas.
Un véritable framework doit permettre de reconstruire la dynamique de décision.
Le registre devrait donc intégrer des informations beaucoup plus significatives :
Detection timestamp
Awareness timestamp
Classification started
Classification completed
Major / non-major
Rationale
Decision maker
Regulatory notification required
Initial notification timestamp
Intermediate report timestamp
Final report timestamp
Critical function impacted
ICT third party involved
Root cause
Financial impact
Remediation
Closure validation
Le changement semble subtil.
Il est en réalité majeur.
On passe d’un incident log à un regulatory decision log.
11. Le rôle des prestataires ICT crée un autre risque : “nous attendions leur analyse”
Imaginons qu’un incident survienne chez un prestataire critique.
L’entité financière demande des informations.
Le prestataire répond :
« Investigation ongoing. »
Deux heures plus tard :
« No further information available. »
Six heures plus tard :
« Root cause still under investigation. »
Le danger serait de considérer que l’horloge réglementaire est suspendue jusqu’à ce que le prestataire ait terminé son analyse.
Ce raisonnement peut être problématique.
L’entité financière reste responsable de ses propres obligations DORA.
Elle doit donc disposer d’un mécanisme permettant d’évaluer l’incident sur la base des informations disponibles à chaque moment, quitte à mettre à jour ensuite son appréciation.
Le principe devrait être simple :
L’incertitude du fournisseur ne doit jamais devenir l’absence de décision de l’entité financière.
C’est précisément pour cette raison que les contrats, mécanismes d’escalade, SLA, obligations de notification et accès aux informations des prestataires ICT deviennent stratégiques.
12. Un Board ne devrait pas recevoir seulement une liste d’incidents
La gouvernance mérite également d’évoluer.
Un Board ou un senior management ne gagne pas nécessairement beaucoup à recevoir :
« 14 incidents ICT ce trimestre. »
Ce chiffre ne dit presque rien.
Un reporting DORA beaucoup plus mature présenterait par exemple :
14 incidents ICT identifiés
dont
3 incidents ayant déclenché une analyse formelle DORA
dont
1 classifié comme majeur
avec
100 % des notifications effectuées dans les délais réglementaires
temps médian entre detection et awareness : X
temps médian entre awareness et classification : Y
2 incidents impliquant un ICT third-party provider
3 remediation actions encore ouvertes
1 recurring root cause identifiée
Cette information permet à l’organe de gouvernance de comprendre réellement :
où se situent les vulnérabilités ;
si les incidents sont correctement détectés ;
si la classification fonctionne ;
si les escalades sont rapides ;
et si les mêmes défaillances se répètent.
Le reporting cesse alors d’être descriptif.
Il devient décisionnel.
13. Les KPI les plus intéressants ne sont peut-être pas ceux que l’on croit
Certaines organisations suivent principalement :
Number of ICT incidents
ou
Number of major incidents.
Ce sont des données utiles.
Mais des KPI de maturité beaucoup plus révélateurs pourraient être :
Mean Time to Detect — MTTD
Combien de temps s’écoule entre l’apparition de l’incident et sa détection ?
Mean Time to Regulatory Awareness
Combien de temps avant que les fonctions nécessaires à la classification DORA soient informées ?
Mean Time to Classify
Combien de temps entre l’awareness et la décision réglementaire ?
Reporting Timeliness
Quel pourcentage de notifications respecte les délais applicables ?
Classification Reassessment Rate
Combien d’incidents ont dû être reclassifiés après réception d’informations nouvelles ?
Recurring Incident Rate
Combien d’incidents résultent d’une cause déjà identifiée précédemment ?
Overdue Remediation Rate
Combien d’actions correctrices restent ouvertes après leur échéance ?
Ces indicateurs mesurent quelque chose de beaucoup plus profond :
la capacité de l’organisation à apprendre et décider sous contrainte.
14. Le test d’inspection que toute entité pourrait effectuer demain
Une organisation souhaitant tester réellement son dispositif pourrait sélectionner cinq incidents récents — y compris des incidents non reportés — et demander à une personne indépendante de reconstruire, uniquement à partir des preuves disponibles :
- À quelle heure l’incident a-t-il commencé ?
- À quelle heure a-t-il été détecté ?
- Quand l’entité en a-t-elle eu connaissance ?
- Quand l’analyse DORA a-t-elle commencé ?
- Quels critères de classification ont été examinés ?
- Quelles données ont été utilisées ?
- Qui a décidé de la classification ?
- Pourquoi l’incident a-t-il été reporté ou non reporté ?
- Les délais réglementaires ont-ils été respectés ?
- Quelles actions ont été prises après l’incident ?
Ce test est extrêmement puissant.
Car si une personne indépendante ne peut pas reconstruire la décision plusieurs semaines plus tard, il peut être difficile d’affirmer qu’un superviseur pourra le faire.
15. Le véritable stress test DORA ne porte donc pas seulement sur les systèmes
Quand on parle de résilience opérationnelle, on pense naturellement :
cyberattaques ;
disaster recovery ;
backups ;
business continuity ;
penetration testing ;
redondance des systèmes.
Tout cela reste évidemment essentiel.
Mais il existe un autre stress test.
Un stress test de gouvernance.
Prenez un vendredi à 17h42.
Une plateforme critique tombe.
Le prestataire ne connaît pas encore la cause.
Les équipes opérationnelles sont sous pression.
Le management veut restaurer le service.
Compliance demande des informations.
Risk essaie d’évaluer l’impact.
Les informations arrivent de manière incomplète.
Et l’horloge réglementaire tourne.
La vraie question devient alors :
Votre organisation peut-elle transformer rapidement une information imparfaite en une décision réglementaire documentée ?
C’est probablement l’une des meilleures définitions de la maturité DORA.
16. “Show me why you did not report it”
Il existe enfin une question que les responsables Risk, Compliance, IT et les dirigeants devraient peut-être garder à l’esprit lors de chaque incident :
« Si la CSSF me demandait dans six mois pourquoi nous n’avons pas reporté cet incident, pourrais-je répondre en moins de cinq minutes ? »
Pas à partir de mes souvenirs.
Pas après avoir interrogé six personnes.
Pas après avoir recherché des messages Teams.
Pas après avoir reconstitué une chronologie à partir de 47 e-mails.
Mais immédiatement.
Avec :
les timestamps ;
les critères ;
les données ;
les validations ;
et la décision.
C’est probablement là que se trouve la frontière entre un processus de gestion d’incident et un véritable dispositif de gouvernance DORA.
Conclusion — Sous DORA, l’incident est un événement ; la preuve de sa maîtrise est un processus réglementaire
DORA change profondément la manière dont les organisations financières doivent penser les incidents informatiques.
Le succès ne peut plus être mesuré uniquement par :
« Le système a été restauré. »
La question réglementaire est désormais beaucoup plus large :
Avons-nous détecté l’incident suffisamment tôt ?
Savions-nous quand l’organisation en avait réellement connaissance ?
Avons-nous appliqué les bons critères ?
La décision de classification était-elle justifiable ?
Avons-nous escaladé suffisamment rapidement ?
Les notifications ont-elles été effectuées dans les délais ?
Pouvons-nous le prouver ?
Et surtout :
avons-nous appris quelque chose de l’incident ?
La publication par la CSSF, le 29 septembre 2026, d’instructions opérationnelles complémentaires relatives au reporting des incidents majeurs DORA confirme à quel point la qualité, la cohérence et l’efficacité du processus de notification sont désormais des sujets de supervision très concrets.
Dans ce nouvel environnement, un incident informatique n’est donc pas nécessairement la principale faiblesse.
Une entreprise résiliente peut subir un incident.
Elle peut même subir un incident majeur.
Mais elle doit être capable de démontrer qu’elle l’a :
détecté ;
compris ;
qualifié ;
escaladé ;
reporté lorsque nécessaire ;
remédié ;
et transformé en apprentissage.
Le véritable risque réglementaire commence lorsque cette chaîne ne peut plus être reconstruite.
Et la question que chaque entité financière devrait peut-être poser aujourd’hui à ses équipes IT, Risk et Compliance est extrêmement simple :
« Prenez notre dernier incident ICT significatif. Montrez-moi, minute par minute, comment nous avons décidé qu’il devait — ou ne devait pas — être reporté. »
Si la réponse peut être produite immédiatement, l’organisation possède probablement davantage qu’une procédure DORA.
Elle possède une résilience démontrable.